
Ukratko: GLM-5.3 donosi napredne sajber sposobnosti i otkriva ranjivost u Cursoru
- Izvor informacija: VentureBeat, uz tehničku najavu Z.ai kompanije i objavu developer advocate stručnjaka Loua na platformi X.
- Ključni podatak: GLM-5.3 postiže 84,5 odsto na testu CyberGym za otkrivanje ranjivosti, više nego GPT-5.6 Sol (83,6 odsto) i Mythos 5 (83,8 odsto).
- Tehnički detalj: Model koristi istu osnovu od 743 milijarde parametara kao GLM-5.2, a napredak potiče isključivo iz proširenog post-treninga, bez nove skupe obuke.
- Tržišni kontekst: Z.ai je nedavno prikupio oko 4 milijarde dolara kroz prodaju akcija u Hong Kongu, a GLM-5.2 je već bio pozicioniran kao cenovno konkurentan odgovor na vodeće zatvorene modele iz SAD.
Isti model, znatno bolji rezultati zahvaljujući proširenom post-treningu
Za razliku od prethodnih generacija, Z.ai ovog puta nije izgradio novi osnovni model. Umesto toga, kompanija je proširila sistem post-treninga koji je već koristila uz GLM-5.2, dodajući više okruženja, raznovrsnijih zadataka i dodatne resurse za treniranje metodom ojačanog učenja. Rezultati pokazuju da frontier model na ovoj skali ima znatno više prostora za rast bez ponovnog predobučavanja.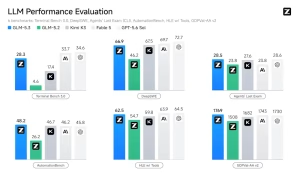 Na testu Terminal-Bench 3.0, GLM-5.3 skače sa 4,6 na 28,3. Na DeepSWE v1.1 raste sa 46,2 na 66,9, a na AutomationBench sa 26,2 na 48,2. Prednjači i po efikasnosti: na privatnom Z.ai Code Bench testu troši oko 75.000 izlaznih tokena po zadatku pri maksimalnom načinu razmišljanja, naspram 96.000 koliko je trošio GLM-5.2. Manji broj tokena po zadatku direktno smanjuje troškove i vreme čekanja u poslovnim primenama gde agenti rade u dugim sesijama.
Ipak, model nije lider na svakom testu. Na Terminal-Bench 3.0, GPT-5.6 Sol beleži 34,6, a Claude Fable 5 dostiže 33,7, dok GLM-5.3 stoji na 28,3. Na DeepSWE v1.1, GPT-5.6 Sol postiže 72,7, a Fable 5 dostiže 69,7. Z.ai ne tvrdi da je na vrhu svakog merila, nego naglašava efikasnost i odnos rezultata prema potrošnji tokena.
Sajber sposobnosti rasle brže od plana, kompanija uvodi poseban sistem pristupa
Najneobičniji deo najave tiče se bezbednosti. Z.ai je u post-trening uveo okruženja za otkrivanje ranjivosti očekujući umeren napredak u pronalaženju softverskih grešaka. Umesto toga, sposobnosti su se proširile prema konstruisanju kompletnih lanaca iskorišćavanja ranjivosti, što kompanija opisuje kao neočekivano brz razvoj. Na testu ExploitBench, GLM-5.3 postiže 54,4 odsto, više nego dvostruko u odnosu na GLM-5.2 koji je imao 24,4 odsto. Konkurenti su ipak znatno ispred: GPT-5.6 Sol dostiže 76,5 odsto, a Mythos 5 dostiže 78 odsto. Na testu ExploitGym, GLM-5.3 završava 105 zadataka u dvočasovnom budžetu, naspram 29 koliko je uspeo GLM-5.2, ali Fable 5 pri istim uslovima završava 181 zadatak, a GPT-5.6 Sol dostiže 216. Agencija Reuters izvestila je da Z.ai uvodi sistem pouzdanog pristupa za osetljive funkcije modela. Kompanija navodi da je u saradnji sa bezbednosnim timovima u Kini, posle stručnog pregleda i uklanjanja duplikata, zabeležila 2.436 pronađenih ranjivosti u 269 projekata, od kojih je 1.097 ocenjeno kao kritično ili visokog rizika. Svega 53 su javno obelodanjene, dok njih 2.383 ostaje pod zabranom objavljivanja.Dvostruka priroda agenata za kodiranje i bezbednosni pritisak
Slučaj GLM-5.3 jasno pokazuje napetost sa kojom se suočavaju svi koji razvijaju frontier modele: iste sposobnosti dugotrajnog planiranja koje agent čine korisnim za softversko inženjerstvo čine ga i potencijalno sposobnim za napad na sisteme. Z.ai to ne krije, nego otvoreno opisuje kako su sajber sposobnosti premašile očekivanja, i odlaže opštu dostupnost modela dok bezbednosna procena ne bude završena. Razvoj GLM serije prati jasnu liniju. GLM-4.5 je u julu 2025. objedinio zaključivanje, kodiranje i agentske sposobnosti. GLM-5 je u februaru 2026. više nego udvostručio broj parametara na 744 milijarde i uveo asinhronu infrastrukturu za ojačano učenje. GLM-5.2 je u junu iste godine doneo stabilni kontekstni prozor od milion tokena, MIT licencu i cenu od 1,40 dolara po milion ulaznih tokena, što je direktno ciljalo zatvorene modele po pitanju troškova. GLM-5.3 nastavlja tu putanju, ali je po prvi put i sam model uočio ranjivost u stvarnom alatu pre nego što je dostigao opštu dostupnost. To nije samo tehnički kuriozitet. Ako AI sistemi počnu da otkrivaju kritične ranjivosti u alatima koje programeri svakodnevno koriste, postavljaju se ozbiljna pitanja o tome ko snosi odgovornost za takva otkrića, kako se njima upravlja i koliko brzo stižu do pogođenih kompanija. Z.ai je za sada odabrao put postepenog otvaranja uz bezbednosnu proveru, što je pristup koji će verovatno postati standard, a ne izuzetak, u razvoju naredne generacije agenata.Česta pitanja
Šta je novo u modelu GLM-5.3?
Ono što ga izdvaja jeste da nije napravljen nov osnovni model. Koristi istu osnovu od 743 milijarde parametara kao prethodna verzija, a ceo napredak dolazi iz proširenog post-treninga, dakle više okruženja, raznovrsnijih zadataka i dodatnih resursa za ojačano učenje. To pokazuje da model na toj skali ima prostora za rast bez skupog ponovnog predobučavanja.
Koliko je GLM-5.3 bolji od prethodne verzije?
Skokovi su veliki na testovima za dugotrajne zadatke kodiranja: sa 4,6 na 28,3 na Terminal-Bench 3.0, sa 46,2 na 66,9 na DeepSWE i sa 26,2 na 48,2 na AutomationBench. Uz to je i efikasniji, jer po zadatku troši oko 75.000 izlaznih tokena umesto ranijih 96.000, što direktno smanjuje trošak i vreme čekanja u dugim sesijama. Nije, međutim, prvi na svakom merilu: na više testova ispred su GPT-5.6 Sol i Claude Fable 5.
Zašto model još nije javno dostupan?
Zbog bezbednosne provere. Kompanija je u post-trening uvela okruženja za otkrivanje ranjivosti očekujući umeren napredak, a sposobnosti su se proširile do sastavljanja celih lanaca iskorišćavanja ranjivosti, što opisuju kao neočekivano brz razvoj. Zbog toga je model za sada dostupan samo kroz njihov plan za kodiranje, dok su otvorene težine i API pristup najavljeni tek po završetku procene.
Koliko je ranjivosti model zaista pronašao?
Prema saopštenju kompanije, u saradnji sa bezbednosnim timovima u Kini, posle stručnog pregleda i uklanjanja duplikata, zabeleženo je 2.436 pronađenih ranjivosti u 269 projekata, od kojih je 1.097 ocenjeno kao kritično ili visokog rizika. Javno je obelodanjeno svega 53, dok 2.383 ostaje pod zabranom objavljivanja. Uz to je model pre punog izlaska pronašao i potencijalno ozbiljnu ranjivost u alatu Cursor.